Kubernetes · Capítulo 3
Scheduling no Kubernetes
Como o Kubernetes decide em qual nó vai cada Pod: labels, taints e tolerations, node affinity, recursos, DaemonSets, Static Pods e schedulers personalizados.
Quando você cria um Pod, alguém precisa decidir em qual nó ele vai rodar. Esse alguém é o kube-scheduler, que vimos no capítulo de fundamentos. Neste capítulo veremos como ele toma essa decisão e todas as formas que temos de influenciá-la.
Como o scheduler decide
O scheduler observa os Pods que ainda não têm nó atribuído (o campo nodeName está vazio).
Para cada um, ele segue estas fases:
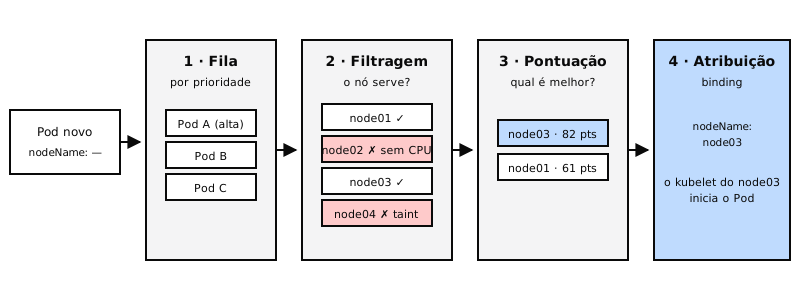
- Fila: os Pods pendentes aguardam a vez, ordenados por prioridade.
- Filtragem: descarta os nós que não servem (sem CPU ou memória suficiente, com um taint que o Pod não tolera, que não cumprem sua afinidade...).
- Pontuação: ordena os nós restantes, por exemplo preferindo o que tem mais recursos livres ou o que já tem a imagem baixada.
- Atribuição (binding): grava o nó escolhido no campo
nodeNamedo Pod. A partir daí, o kubelet desse nó o inicia.
Scheduling manual com nodeName
Você pode pular o scheduler indicando o nó no spec do Pod:
apiVersion: v1
kind: Pod
metadata:
  name: nginx
spec:
  nodeName: node02
  containers:
    - name: nginx
      image: nginx
- Só pode ser indicado ao criar o Pod. Depois, o
nodeNamenão pode ser modificado. - Para atribuir um Pod já criado, envia-se um objeto Binding à API (é o que o scheduler faz internamente).
- Se não houver scheduler no cluster, os Pods sem
nodeNameficam no estadoPending.
Labels, seletores e anotações
São a base de quase tudo o que vem a seguir:
- Labels: pares chave-valor para agrupar recursos (
app: miapp,env: prod). - Seletores: a forma de filtrar por essas labels.
- Anotações: metadados informativos que não servem para seleção: versão, contato, dados do build etc.
kubectl get pods --selector app=miapp
kubectl get pods -l env=prod,tier=front-end
Os ReplicaSets, Deployments e Services usam seletores para encontrar seus Pods. Repare que contam
as labels do modelo do Pod (spec.template.metadata.labels), e não as do metadata do
próprio ReplicaSet.
metadata:
  name: miapp
  labels:
    app: miapp            # labels do objeto, para que outros o encontrem
  annotations:
    buildversion: "1.34"  # informação, não é usada para seleção
Taints e tolerations
Servem para que um nó rejeite Pods, exceto os que estão preparados para ele:
- Um taint ("mancha") é colocado no nó. Por padrão, nenhum Pod o tolera.
- Uma toleration é colocada no Pod e permite que ele seja alocado em nós com esse taint.
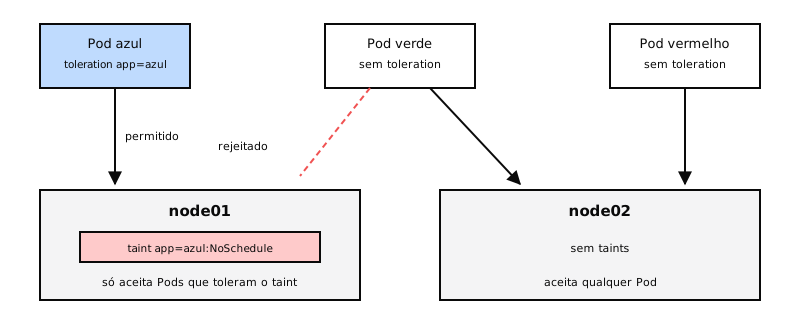
Importante: uma toleration não obriga o Pod a ir para esse nó. Ela só dá permissão. O Pod pode acabar em qualquer outro nó sem taints. Para direcioná-lo a um nó específico usa-se a afinidade, que veremos em seguida.
Passo 1: colocar o taint no nó
kubectl taint nodes node01 app=azul:NoSchedule

# Removê-lo (com um hífen no final)
kubectl taint nodes node01 app=azul:NoSchedule-
| Efeito | O que faz com os Pods que não o toleram |
|---|---|
NoSchedule |
Não aloca novos Pods no nó. |
PreferNoSchedule |
Tenta evitar o nó, mas não garante. |
NoExecute |
Não aloca novos Pods e expulsa os que já estavam lá. |
Passo 2: tornar o Pod tolerante
apiVersion: v1
kind: Pod
metadata:
  name: app-azul
spec:
  containers:
    - name: web
      image: nginx
  tolerations:
    - key: "app"
      operator: "Equal"
      value: "azul"
      effect: "NoSchedule"
É por isso que não se alocam Pods de aplicações no plano de controle: seus nós têm o taint
node-role.kubernetes.io/control-plane:NoSchedule.
nodeSelector: escolher nós por label
A forma mais simples de direcionar um Pod a certos nós. Primeiro você rotula o nó e depois o pede no Pod:
kubectl label nodes node01 size=large
spec:
  nodeSelector:
    size: large
  containers:
    - name: procesador
      image: mi-procesador
Seu limite: só aceita igualdades. Não dá para pedir "nós grandes ou médios" nem "qualquer nó que não seja pequeno". Para isso existe a afinidade.
Node affinity
A afinidade de nó é a versão avançada do nodeSelector: aceita operadores (In, NotIn,
Exists, DoesNotExist, Gt, Lt) e regras obrigatórias ou preferidas.
spec:
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
          - matchExpressions:
              - key: size
                operator: In
                values: ["large", "medium"]
  containers:
    - name: procesador
      image: mi-procesador
Os nomes longos descrevem o comportamento em dois momentos:
| Tipo | Ao alocar o Pod | Se o nó mudar depois |
|---|---|---|
requiredDuringSchedulingIgnoredDuringExecution |
Obrigatório: se nenhum nó cumprir, o Pod fica Pending. |
É ignorado: o Pod continua onde está. |
preferredDuringSchedulingIgnoredDuringExecution |
Preferido: se nenhum nó cumprir, ele vai para outro. | É ignorado. |
Para "qualquer nó que não seja pequeno" você usaria operator: NotIn com values: ["small"].
Taints e tolerations ou affinity
Resolvem problemas diferentes e costumam ser usados juntos:
- Taints e tolerations impedem que outros Pods entrem nos seus nós.
- A node affinity garante que os seus Pods vão para os seus nós.
Para reservar alguns nós para uma aplicação: taint nesses nós, toleration nos Pods da aplicação e afinidade para que esses Pods não acabem em outros nós.
Requests e limits de recursos
Cada contêiner pode declarar quanto de CPU e memória precisa e quanto pode usar no máximo:
spec:
  containers:
    - name: web
      image: nginx
      resources:
        requests:
          cpu: "250m"      # 0,25 núcleo
          memory: "256Mi"
        limits:
          cpu: "500m"
          memory: "512Mi"
- requests é o que o scheduler usa: ele só coloca o Pod em um nó com essa capacidade livre.
- limits é o teto durante a execução, e se comporta de forma diferente conforme o recurso:
| Recurso | Se o contêiner tentar passar do limite |
|---|---|
| CPU | É freado (throttling): fica mais lento, mas continua vivo. |
| Memória | O contêiner é encerrado com o erro OOMKilled (sem memória). |
Por padrão, o Kubernetes não define requests nem limits. Uma prática comum: definir sempre requests e, para CPU, ter cuidado com os limits, porque eles freiam mesmo quando o nó tem CPU livre.
Dois objetos de namespace definem valores padrão:
- LimitRange: valores padrão, mínimos e máximos por contêiner.
- ResourceQuota: o total que todo o namespace pode consumir.
DaemonSets: um Pod em cada nó
Um DaemonSet garante que haja uma cópia de um Pod em cada nó do cluster. Quando um nó é adicionado, ele cria o Pod nele; quando um nó é removido, ele o apaga.
É o que se usa para agentes que precisam estar em todos os lugares: monitoramento, coleta de logs ou a rede do cluster (o kube-proxy é implantado assim).
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: agente-monitoreo
spec:
  selector:
    matchLabels:
      app: agente-monitoreo
  template:
    metadata:
      labels:
        app: agente-monitoreo
    spec:
      containers:
        - name: agente
          image: agente-monitoreo
kubectl get daemonsets
kubectl describe daemonset agente-monitoreo
Desde o Kubernetes 1.12, os DaemonSets usam o scheduler normal junto com regras de afinidade de nó para alocar cada Pod.
Static Pods
O kubelet pode funcionar sem o plano de controle: se você lhe der uma pasta com arquivos YAML de Pods, ele os cria e os mantém vivos por conta própria. São os Static Pods.
- A pasta é configurada no kubelet (
staticPodPathna configuração dele). O habitual é/etc/kubernetes/manifests. - Se você adiciona um arquivo, o kubelet cria o Pod; se o modifica, ele o recria; se o apaga, o Pod desaparece.
- Se o nó faz parte de um cluster, o kubelet publica uma cópia somente leitura (mirror Pod) para
que ele apareça em
kubectl get pods, com o nome do nó como sufixo. - É assim que o kubeadm inicia o próprio plano de controle: kube-apiserver, etcd, kube-scheduler e kube-controller-manager são Static Pods nos nós do plano de controle.
Para vê-los no nó sem passar pela API: crictl ps.
| Static Pods | DaemonSets | |
|---|---|---|
| Quem os cria | O kubelet, a partir de arquivos locais | O plano de controle, por meio da API |
| Onde | Só no nó que tem esses arquivos | Em todos os nós (ou nos que você indicar) |
| Uso típico | Componentes do plano de controle | Agentes de monitoramento e logs |
| O scheduler os ignora | Sim | Não |
Vários schedulers e perfis
O Kubernetes permite schedulers personalizados que convivem com o padrão. Cada um tem um nome, e cada Pod escolhe por qual será alocado:
spec:
  schedulerName: mi-scheduler
  containers:
    - name: nginx
      image: nginx
Um scheduler adicional é implantado como qualquer outro Pod ou Deployment, com seu próprio arquivo de configuração:
apiVersion: kubescheduler.config.k8s.io/v1
kind: KubeSchedulerConfiguration
profiles:
  - schedulerName: mi-scheduler
Para saber qual scheduler alocou cada Pod:
kubectl get events -o wide
kubectl logs mi-scheduler -n kube-system
Plugins e pontos de extensão
O scheduler é construído com plugins, cada um ligado a uma fase (um ponto de extensão):
| Fase | Exemplos de plugins nativos |
|---|---|
queueSort |
PrioritySort (ordena por prioridade) |
filter |
NodeResourcesFit, NodeName, NodeUnschedulable, TaintToleration, NodeAffinity |
score |
NodeResourcesFit, ImageLocality |
bind |
DefaultBinder |
Também existem pontos intermediários (preFilter, postFilter, preScore, reserve, permit,
preBind, postBind) onde é possível adicionar plugins próprios.
Em vez de manter vários schedulers separados, um mesmo kube-scheduler pode ter vários perfis,
cada um com seu schedulerName e sua combinação de plugins ativados ou desativados:
apiVersion: kubescheduler.config.k8s.io/v1
kind: KubeSchedulerConfiguration
profiles:
  - schedulerName: default-scheduler
  - schedulerName: sin-puntuacion
    plugins:
      score:
        disabled:
          - name: "*"
Ideias-chave
- O scheduler filtra os nós, pontua e atribui o Pod gravando seu
nodeName. - O
nodeNamepermite alocar à mão, só ao criar o Pod. - Labels agrupam, seletores filtram e anotações só informam.
- Taints nos nós e tolerations nos Pods: o nó rejeita quem não o tolera.
NoExecutetambém expulsa. - O nodeSelector direciona Pods por igualdade de labels; a node affinity acrescenta operadores e regras obrigatórias ou preferidas.
- Os requests decidem onde um Pod cabe; passar do limit de CPU freia, passar do de memória provoca OOMKilled.
- DaemonSet: um Pod por nó. Static Pod: criado pelo kubelet a partir de arquivos locais.
- É possível usar vários schedulers ou perfis, escolhidos com
schedulerName.