Kubernetes · Capítulo 2
Recursos do Kubernetes
Pods, ReplicaSets e Deployments, como são atualizados e revertidos, a abordagem declarativa com kubectl apply e a organização com Namespaces.
No capítulo anterior vimos a arquitetura do cluster. Agora é a vez do que se implanta nele: os recursos (ou objetos) do Kubernetes. Vamos percorrer a cadeia que você usará todos os dias, Pod → ReplicaSet → Deployment, ver como atualizar uma aplicação sem interrupções e como organizar tudo com Namespaces.
Pods: a unidade mínima
O Kubernetes não executa contêineres soltos: ele os envolve em um Pod, a menor unidade que pode ser criada e alocada em um nó.
- O normal é um contêiner por Pod. Para escalar, criam-se mais Pods, não mais contêineres dentro do mesmo Pod.
- Um Pod pode ter vários contêineres quando eles trabalham juntos de forma inseparável. Por
exemplo, um sidecar que coleta logs ou o proxy de uma service mesh. Esses contêineres
compartilham a rede (enxergam-se em
localhost) e o armazenamento.
Definir um Pod em YAML
Todo objeto do Kubernetes é descrito com quatro campos de primeiro nível:
| Campo | Para que serve |
|---|---|
apiVersion |
Versão da API do objeto (v1 para Pods). |
kind |
Tipo de objeto: Pod, ReplicaSet, Deployment... |
metadata |
Nome, labels e outros dados do objeto. |
spec |
O estado desejado: em um Pod, seus contêineres. |
apiVersion: v1
kind: Pod
metadata:
  name: mi-pod
  labels:
    app: miapp
    tier: front-end
spec:
  containers:
    - name: web
      image: nginx
      ports:
        - containerPort: 80
Comandos básicos
# Criar um Pod rápido, sem YAML (a imagem precisa existir no registro)
kubectl run nginx --image=nginx

# Criar ou atualizar a partir do arquivo
kubectl apply -f mi-pod.yaml

# Consultar
kubectl get pods                 # Pods do namespace atual
kubectl get pods -o wide         # com o IP e o nó de cada Pod
kubectl get pods -A              # Pods de todos os namespaces
kubectl describe pod nginx       # detalhes e eventos do Pod
ReplicaSets: várias cópias, sempre vivas
Um Pod sozinho não é resiliente: se ele morre, ninguém o substitui. O ReplicaSet é um controlador que garante que sempre haja um número determinado de Pods iguais em execução:
- Alta disponibilidade: se um Pod cai, ele cria outro.
- Escalabilidade e distribuição de carga: as réplicas podem ser distribuídas entre vários nós.
Seu antecessor era o ReplicationController, hoje considerado legado. O ReplicaSet faz o mesmo e acrescenta um seletor mais flexível.
Seletor e labels: como ele sabe quais Pods vigiar
O ReplicaSet não "lembra" dos Pods que criou: ele os encontra pelas labels. O campo
selector.matchLabels diz quais labels os Pods que pertencem a ele devem ter, e o modelo
(template) define como criar os que faltarem.
apiVersion: apps/v1
kind: ReplicaSet
metadata:
  name: miapp-replicaset
  labels:
    app: miapp
spec:
  replicas: 3
  selector:
    matchLabels:
      app: miapp
      tier: front-end
  template:                 # modelo dos Pods
    metadata:
      labels:
        app: miapp          # devem coincidir com o seletor
        tier: front-end
    spec:
      containers:
        - name: web
          image: nginx
          ports:
            - containerPort: 80
Duas consequências importantes:
- Um ReplicaSet pode adotar Pods que já existiam se eles tiverem as labels do seletor.
- Se você criar à mão um Pod com essas mesmas labels e o número de réplicas já tiver sido atingido, o ReplicaSet o remove: ele nunca deixa haver mais cópias do que o indicado.
Escalar um ReplicaSet
kubectl get replicasets            # ou: kubectl get rs
kubectl describe rs miapp-replicaset

# Opção 1: mudar replicas no YAML e aplicar
kubectl replace -f miapp-replicaset.yaml

# Opção 2: escalar pela linha de comando
kubectl scale rs miapp-replicaset --replicas=6
Atenção: o
kubectl scalemuda o objeto no cluster, não o seu arquivo YAML. Se depois você aplicar o arquivo, voltará ao número de réplicas que o arquivo indica.
Deployments: a forma habitual de implantar
Na prática, quase nunca se criam ReplicaSets à mão. Usa-se um Deployment, um objeto de nível superior que cria e gerencia ReplicaSets por você e acrescenta o que um ReplicaSet não sabe fazer: atualizar a aplicação de forma controlada e voltar atrás.
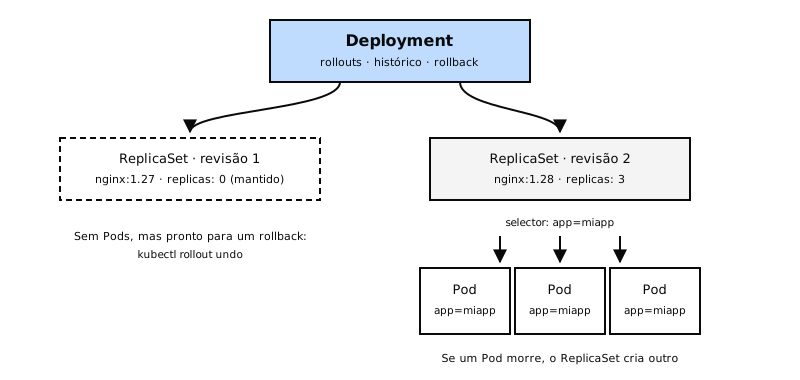
Seu YAML é quase idêntico ao do ReplicaSet; muda apenas o kind:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: miapp-deployment
  labels:
    app: miapp
spec:
  replicas: 3
  selector:
    matchLabels:
      app: miapp
  template:
    metadata:
      labels:
        app: miapp
    spec:
      containers:
        - name: web
          image: nginx:1.27
          ports:
            - containerPort: 80
kubectl apply -f miapp-deployment.yaml
kubectl get deployments
kubectl get rs          # o ReplicaSet criado pelo Deployment
kubectl get pods
kubectl get all         # tudo o que foi listado acima de uma vez
Rollouts, revisões e rollback
Cada vez que você muda o modelo de Pods de um Deployment (por exemplo, a imagem), o Kubernetes inicia um rollout e guarda uma revisão. Por dentro, o Deployment cria um novo ReplicaSet com a nova versão e vai passando os Pods do ReplicaSet antigo para o novo.
# Acompanhar o progresso e ver o histórico
kubectl rollout status deployment/miapp-deployment
kubectl rollout history deployment/miapp-deployment

# Atualizar a imagem sem editar o arquivo
kubectl set image deployment/miapp-deployment web=nginx:1.28

# Voltar à revisão anterior (ou a uma específica)
kubectl rollout undo deployment/miapp-deployment
kubectl rollout undo deployment/miapp-deployment --to-revision=1
Como o ReplicaSet anterior é mantido (com zero réplicas), o rollback é rápido: o Kubernetes só precisa escalá-lo de novo.
Sobre o
--record: muitos guias usamkubectl apply --recordpara guardar o comando no histórico. Essa opção está obsoleta. Hoje se anota o motivo da mudança assim:kubectl annotate deployment/miapp-deployment kubernetes.io/change-cause="nginx 1.28"
Estratégias de implantação
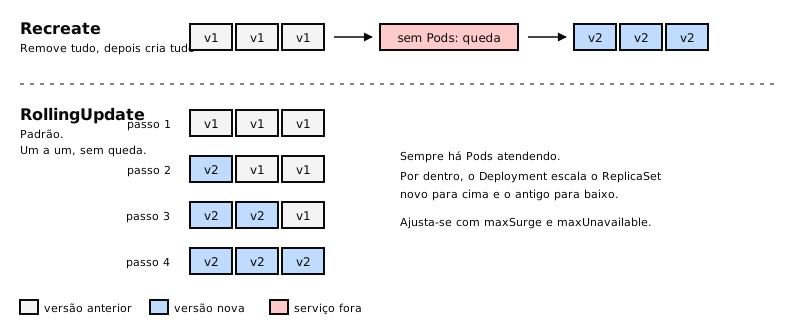
| Estratégia | Como funciona | Há interrupção? |
|---|---|---|
| RollingUpdate (padrão) | Substitui os Pods aos poucos: cria um novo, remove um antigo, e assim por diante. | Não |
| Recreate | Remove todos os Pods antigos e depois cria todos os novos. | Sim, enquanto os novos iniciam |
A escolha é feita em spec.strategy.type do Deployment.
Imperativo e declarativo
Há duas formas de trabalhar com o Kubernetes:
- Imperativa: você diz ao sistema o que fazer e como, passo a passo: crie isto, mude aquilo, apague o outro.
- Declarativa: você descreve o estado final em arquivos e o sistema calcula quais mudanças são necessárias para chegar a ele.
| Imperativo | Declarativo |
|---|---|
kubectl run, kubectl create, kubectl expose |
kubectl apply -f arquivo.yaml |
kubectl scale, kubectl set image |
kubectl apply -f pasta/ |
kubectl edit (muda o cluster, não o seu arquivo) |
O arquivo é a fonte da verdade |
kubectl replace --force -f (apaga e recria) |
Pode ser versionado no Git |
O imperativo é útil para testes rápidos e em provas com tempo limitado. Para ambientes reais, o declarativo é o recomendado: o arquivo no Git sempre reflete o que há no cluster.
Como funciona o kubectl apply
O kubectl apply compara três versões de cada objeto para decidir o que mudar:
- Seu arquivo local (o que você quer).
- O objeto vivo no cluster (o que existe).
- A última configuração aplicada, que o Kubernetes guarda em formato JSON como anotação do
objeto, com a chave
kubectl.kubernetes.io/last-applied-configuration.
Graças à terceira, o apply sabe se você removeu um campo do arquivo e deve apagá-lo do objeto
vivo, em vez de deixá-lo como estava. Se o objeto não existe, ele simplesmente o cria.
Namespaces: organizar o cluster
Um Namespace é um espaço isolado dentro do cluster, com seus próprios recursos, permissões e limites. Serve para separar ambientes (desenvolvimento, testes, produção) ou equipes.
O Kubernetes traz vários de fábrica:
| Namespace | Para que é usado |
|---|---|
default |
Onde os recursos são criados se você não indicar outro. |
kube-system |
Componentes internos do Kubernetes. Não se mexe. |
kube-public |
Recursos legíveis por todos os usuários, mesmo sem autenticação. |
kube-node-lease |
Sinais de vida (heartbeats) dos nós. |
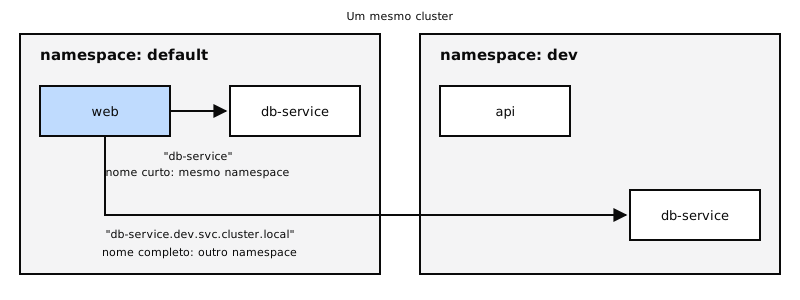
Nomes DNS entre namespaces
Dentro do mesmo namespace, um serviço é acessado pelo nome (db-service). Para chegar a um de
outro namespace, usa-se o nome completo:
db-service.dev.svc.cluster.local
└─serviço──┘└ns┘└tipo┘└─domínio do cluster─┘
Trabalhar com namespaces
# Criar
kubectl create namespace dev

# Ver recursos de um namespace específico ou de todos
kubectl get pods --namespace=dev
kubectl get pods --all-namespaces

# Mudar o namespace padrão do seu contexto
kubectl config set-context --current --namespace=dev
Para que um objeto seja sempre criado em um namespace, coloque-o no metadata:
metadata:
  name: mi-pod
  namespace: dev
Limitar recursos com ResourceQuota
Um ResourceQuota define o máximo de recursos que um namespace pode consumir no total:
apiVersion: v1
kind: ResourceQuota
metadata:
  name: cuota-dev
  namespace: dev
spec:
  hard:
    pods: "10"
    requests.cpu: "4"
    requests.memory: 5Gi
    limits.cpu: "10"
    limits.memory: 10Gi
Ideias-chave
- O Pod é a unidade mínima; normalmente tem um único contêiner.
- Todo objeto tem
apiVersion,kind,metadataespec. - O ReplicaSet mantém N cópias de um Pod e as encontra pelas labels com seu
selector. - O Deployment gerencia ReplicaSets e acrescenta rollouts, histórico e rollback.
- O RollingUpdate (padrão) não interrompe o serviço; o Recreate, sim.
- O declarativo (
kubectl apply) é o recomendado; oapplyusa a anotaçãolast-applied-configurationpara calcular as mudanças. - Os Namespaces separam recursos; entre eles usa-se o DNS
servico.namespace.svc.cluster.local, e um ResourceQuota limita seu consumo.
No próximo capítulo: scheduling, como o Kubernetes decide em qual nó vai cada Pod.