Kubernetes · Chapitre 3
Le scheduling dans Kubernetes
Comment Kubernetes décide sur quel nœud s'exécute chaque Pod : labels, taints et tolerations, node affinity, ressources, DaemonSets, Static Pods et schedulers personnalisés.
Quand vous créez un Pod, quelqu'un doit décider sur quel nœud il s'exécute. Ce quelqu'un est le kube-scheduler, que nous avons vu dans le chapitre des fondamentaux. Dans ce chapitre, nous verrons comment il prend cette décision et toutes les façons de l'influencer.
Comment le scheduler décide
Le scheduler surveille les Pods qui n'ont pas encore de nœud attribué (leur champ nodeName
est vide). Pour chacun, il suit ces phases :
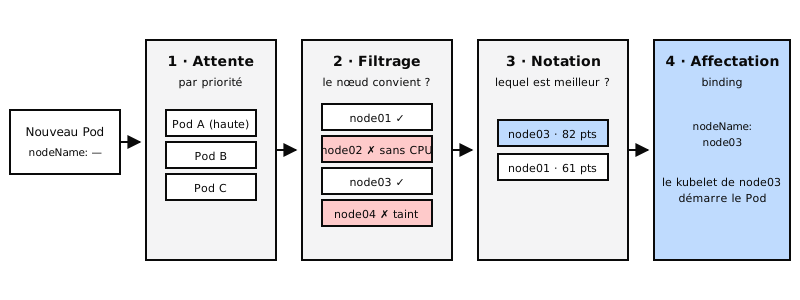
- File d'attente : les Pods en attente patientent, classés par priorité.
- Filtrage : il écarte les nœuds qui ne conviennent pas (pas assez de CPU ou de mémoire, un taint que le Pod ne tolère pas, une affinité non respectée...).
- Notation : il classe les nœuds restants, par exemple en préférant celui qui a le plus de ressources libres ou celui qui possède déjà l'image.
- Affectation (binding) : il écrit le nœud retenu dans le champ
nodeNamedu Pod. À partir de là, le kubelet de ce nœud le démarre.
Scheduling manuel avec nodeName
Vous pouvez contourner le scheduler en indiquant vous-même le nœud dans le spec du Pod :
apiVersion: v1
kind: Pod
metadata:
  name: nginx
spec:
  nodeName: node02
  containers:
    - name: nginx
      image: nginx
- On ne peut l'indiquer qu'à la création du Pod. Ensuite,
nodeNamen'est plus modifiable. - Pour affecter un Pod déjà créé, on envoie un objet Binding à l'API (c'est ce que fait le scheduler en interne).
- S'il n'y a pas de scheduler dans le cluster, les Pods sans
nodeNamerestent à l'étatPending.
Labels, sélecteurs et annotations
Ils sont la base de presque tout ce qui suit :
- Labels : paires clé-valeur pour regrouper des ressources (
app: miapp,env: prod). - Sélecteurs : le moyen de filtrer par ces labels.
- Annotations : métadonnées informatives qui ne servent pas à la sélection : version, contact, détails du build, etc.
kubectl get pods --selector app=miapp
kubectl get pods -l env=prod,tier=front-end
Les ReplicaSets, Deployments et Services utilisent des sélecteurs pour trouver leurs Pods. Notez
que ce sont les labels du modèle de Pod (spec.template.metadata.labels) qui comptent, et non
ceux du metadata du ReplicaSet lui-même.
metadata:
  name: miapp
  labels:
    app: miapp            # labels de l'objet, pour que d'autres le trouvent
  annotations:
    buildversion: "1.34"  # information, non utilisée pour la sélection
Taints et tolerations
Ils permettent à un nœud de refuser des Pods, sauf ceux qui sont préparés pour lui :
- Un taint (« tache ») se place sur le nœud. Par défaut, aucun Pod ne le tolère.
- Une toleration se place sur le Pod et lui permet d'être placé sur les nœuds portant ce taint.
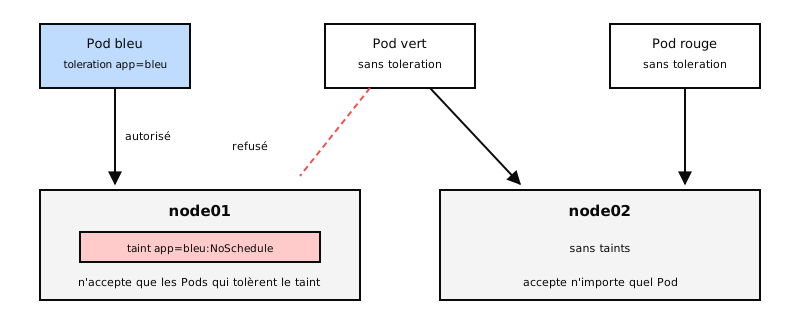
Important : une toleration n'oblige pas le Pod à aller sur ce nœud. Elle lui en donne seulement la permission. Le Pod peut finir sur n'importe quel autre nœud sans taint. Pour le diriger vers un nœud précis, on utilise l'affinité, que nous verrons juste après.
Étape 1 : poser le taint sur le nœud
kubectl taint nodes node01 app=bleu:NoSchedule

# Le retirer (avec un tiret à la fin)
kubectl taint nodes node01 app=bleu:NoSchedule-
| Effet | Ce qu'il fait aux Pods qui ne le tolèrent pas |
|---|---|
NoSchedule |
Ne place pas de nouveaux Pods sur le nœud. |
PreferNoSchedule |
Essaie d'éviter le nœud, sans le garantir. |
NoExecute |
Ne place pas de nouveaux Pods et expulse ceux qui s'y trouvaient. |
Étape 2 : rendre le Pod tolérant
apiVersion: v1
kind: Pod
metadata:
  name: app-bleu
spec:
  containers:
    - name: web
      image: nginx
  tolerations:
    - key: "app"
      operator: "Equal"
      value: "bleu"
      effect: "NoSchedule"
C'est pour cela qu'on ne place pas de Pods applicatifs sur le plan de contrôle : ses nœuds portent
le taint node-role.kubernetes.io/control-plane:NoSchedule.
nodeSelector : choisir des nœuds par label
La façon la plus simple de diriger un Pod vers certains nœuds. On étiquette d'abord le nœud, puis on le demande dans le Pod :
kubectl label nodes node01 size=large
spec:
  nodeSelector:
    size: large
  containers:
    - name: procesador
      image: mi-procesador
Sa limite : il n'accepte que l'égalité. Impossible de demander « des nœuds grands ou moyens » ni « n'importe quel nœud qui n'est pas petit ». C'est le rôle de l'affinité.
Node affinity
L'affinité de nœud est la version avancée de nodeSelector : elle accepte des opérateurs
(In, NotIn, Exists, DoesNotExist, Gt, Lt) et des règles obligatoires ou préférées.
spec:
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
          - matchExpressions:
              - key: size
                operator: In
                values: ["large", "medium"]
  containers:
    - name: procesador
      image: mi-procesador
Les noms à rallonge décrivent le comportement à deux moments :
| Type | Au placement du Pod | Si le nœud change ensuite |
|---|---|---|
requiredDuringSchedulingIgnoredDuringExecution |
Obligatoire : si aucun nœud ne correspond, le Pod reste Pending. |
Ignoré : le Pod reste où il est. |
preferredDuringSchedulingIgnoredDuringExecution |
Préféré : si aucun nœud ne correspond, il va ailleurs. | Ignoré. |
Pour « n'importe quel nœud qui n'est pas petit », on utiliserait operator: NotIn avec
values: ["small"].
Taints et tolerations ou affinité
Ils résolvent des problèmes différents et s'utilisent généralement ensemble :
- Les taints et tolerations empêchent les autres Pods d'entrer sur vos nœuds.
- L'affinité de nœud garantit que vos Pods vont sur vos nœuds.
Pour réserver des nœuds à une application : un taint sur ces nœuds, une toleration sur les Pods de l'application et une affinité pour que ces Pods n'aillent pas sur d'autres nœuds.
Requests et limits de ressources
Chaque conteneur peut déclarer combien de CPU et de mémoire il demande et combien il peut utiliser au maximum :
spec:
  containers:
    - name: web
      image: nginx
      resources:
        requests:
          cpu: "250m"      # 0,25 cœur
          memory: "256Mi"
        limits:
          cpu: "500m"
          memory: "512Mi"
- requests est ce qu'utilise le scheduler : il ne place le Pod que sur un nœud qui a cette capacité libre.
- limits est le plafond pendant l'exécution, et il se comporte différemment selon la ressource :
| Ressource | Si le conteneur essaie de dépasser la limite |
|---|---|
| CPU | Il est bridé (throttling) : il ralentit, mais reste actif. |
| Mémoire | Le conteneur est arrêté avec l'erreur OOMKilled (mémoire épuisée). |
Par défaut, Kubernetes ne fixe ni requests ni limits. Une pratique courante : toujours définir les requests et, pour le CPU, rester prudent avec les limits, car elles brident même quand le nœud a du CPU libre.
Deux objets de namespace fixent des valeurs par défaut :
- LimitRange : valeurs par défaut, minimales et maximales par conteneur.
- ResourceQuota : le total que peut consommer tout le namespace.
Les DaemonSets : un Pod sur chaque nœud
Un DaemonSet garantit une copie d'un Pod sur chaque nœud du cluster. Quand un nœud est ajouté, il y crée le Pod ; quand un nœud est retiré, il le supprime.
On l'utilise pour les agents qui doivent être partout : supervision, collecte de logs ou réseau du cluster (kube-proxy est déployé ainsi).
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: agente-monitoreo
spec:
  selector:
    matchLabels:
      app: agente-monitoreo
  template:
    metadata:
      labels:
        app: agente-monitoreo
    spec:
      containers:
        - name: agente
          image: agente-monitoreo
kubectl get daemonsets
kubectl describe daemonset agente-monitoreo
Depuis Kubernetes 1.12, les DaemonSets utilisent le scheduler normal avec des règles d'affinité de nœud pour placer chaque Pod.
Les Static Pods
Le kubelet peut fonctionner sans le plan de contrôle : si vous lui donnez un dossier contenant des fichiers YAML de Pods, il les crée et les maintient en vie tout seul. Ce sont les Static Pods.
- Le dossier se configure dans le kubelet (
staticPodPathdans sa configuration). En général, c'est/etc/kubernetes/manifests. - Si vous ajoutez un fichier, le kubelet crée le Pod ; si vous le modifiez, il le recrée ; si vous le supprimez, le Pod disparaît.
- Si le nœud fait partie d'un cluster, le kubelet publie une copie en lecture seule (mirror Pod)
pour qu'il apparaisse dans
kubectl get pods, avec le nom du nœud en suffixe. - C'est ainsi que kubeadm démarre le plan de contrôle lui-même : kube-apiserver, etcd, kube-scheduler et kube-controller-manager sont des Static Pods sur les nœuds du plan de contrôle.
Pour les voir sur le nœud sans passer par l'API : crictl ps.
| Static Pods | DaemonSets | |
|---|---|---|
| Qui les crée | Le kubelet, à partir de fichiers locaux | Le plan de contrôle, via l'API |
| Où | Uniquement sur le nœud qui a ces fichiers | Sur tous les nœuds (ou ceux que vous indiquez) |
| Usage typique | Composants du plan de contrôle | Agents de supervision et de logs |
| Ignorés par le scheduler | Oui | Non |
Plusieurs schedulers et profils
Kubernetes permet des schedulers personnalisés qui cohabitent avec celui par défaut. Chacun a un nom, et chaque Pod choisit par lequel il est placé :
spec:
  schedulerName: mi-scheduler
  containers:
    - name: nginx
      image: nginx
Un scheduler supplémentaire se déploie comme n'importe quel Pod ou Deployment, avec son propre fichier de configuration :
apiVersion: kubescheduler.config.k8s.io/v1
kind: KubeSchedulerConfiguration
profiles:
  - schedulerName: mi-scheduler
Pour savoir quel scheduler a placé chaque Pod :
kubectl get events -o wide
kubectl logs mi-scheduler -n kube-system
Plugins et points d'extension
Le scheduler est construit à partir de plugins, chacun rattaché à une phase (un point d'extension) :
| Phase | Exemples de plugins intégrés |
|---|---|
queueSort |
PrioritySort (trie par priorité) |
filter |
NodeResourcesFit, NodeName, NodeUnschedulable, TaintToleration, NodeAffinity |
score |
NodeResourcesFit, ImageLocality |
bind |
DefaultBinder |
Il existe aussi des points intermédiaires (preFilter, postFilter, preScore, reserve,
permit, preBind, postBind) où l'on peut ajouter ses propres plugins.
Plutôt que de maintenir plusieurs schedulers séparés, un même kube-scheduler peut avoir plusieurs
profils, chacun avec son schedulerName et sa propre combinaison de plugins activés ou
désactivés :
apiVersion: kubescheduler.config.k8s.io/v1
kind: KubeSchedulerConfiguration
profiles:
  - schedulerName: default-scheduler
  - schedulerName: sin-puntuacion
    plugins:
      score:
        disabled:
          - name: "*"
À retenir
- Le scheduler filtre les nœuds, les note et affecte le Pod en écrivant son
nodeName. nodeNamepermet un placement manuel, uniquement à la création du Pod.- Les labels regroupent, les sélecteurs filtrent et les annotations ne font qu'informer.
- Taints sur les nœuds et tolerations sur les Pods : le nœud refuse qui ne le tolère pas.
NoExecuteexpulse en plus. - nodeSelector dirige les Pods par égalité de labels ; l'affinité de nœud ajoute des opérateurs et des règles obligatoires ou préférées.
- Les requests décident où un Pod a sa place ; dépasser la limit CPU bride, dépasser celle de mémoire provoque OOMKilled.
- DaemonSet : un Pod par nœud. Static Pod : créé par le kubelet à partir de fichiers locaux.
- On peut utiliser plusieurs schedulers ou profils, choisis avec
schedulerName.