Kubernetes · Capítulo 3
Scheduling en Kubernetes
Cómo decide Kubernetes en qué nodo va cada Pod: labels, taints y tolerations, node affinity, recursos, DaemonSets, Static Pods y schedulers personalizados.
Cuando creas un Pod, alguien tiene que decidir en qué nodo se ejecuta. Ese alguien es el kube-scheduler, que vimos en el capítulo de fundamentos. En este capítulo veremos cómo toma esa decisión y todas las formas que tenemos de influir en ella.
Cómo decide el scheduler
El scheduler vigila los Pods que todavía no tienen nodo asignado (su campo nodeName está
vacío). Para cada uno sigue estas fases:
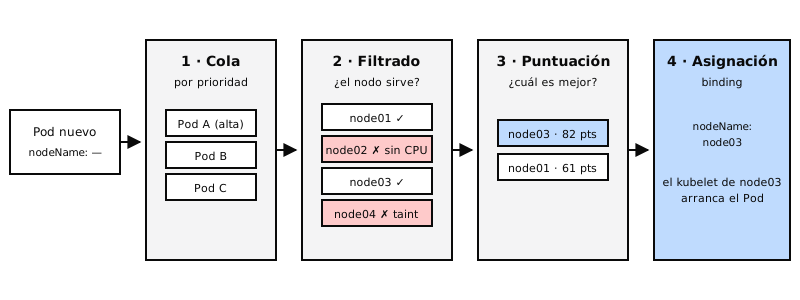
- Cola: los Pods pendientes esperan su turno, ordenados por prioridad.
- Filtrado: descarta los nodos que no sirven (sin CPU o memoria suficiente, con un taint que el Pod no tolera, que no cumplen su afinidad...).
- Puntuación: ordena los nodos que quedan, por ejemplo prefiriendo el que tiene más recursos libres o el que ya tiene la imagen descargada.
- Asignación (binding): escribe el nodo elegido en el campo
nodeNamedel Pod. A partir de ahí, el kubelet de ese nodo lo arranca.
Scheduling manual con nodeName
Puedes saltarte el scheduler indicando tú el nodo en el spec del Pod:
apiVersion: v1
kind: Pod
metadata:
  name: nginx
spec:
  nodeName: node02
  containers:
    - name: nginx
      image: nginx
- Solo se puede indicar al crear el Pod. Después,
nodeNameno se puede modificar. - Para asignar un Pod ya creado se usa un objeto Binding enviado a la API (es lo que hace el scheduler internamente).
- Si no hay scheduler en el clúster, los Pods sin
nodeNamese quedan en estadoPending.
Labels, selectores y anotaciones
Son la base de casi todo lo que sigue:
- Labels: pares clave-valor para agrupar recursos (
app: miapp,env: prod). - Selectores: la forma de filtrar por esas labels.
- Anotaciones: metadatos informativos que no sirven para seleccionar: versión, contacto, datos del build, etc.
kubectl get pods --selector app=miapp
kubectl get pods -l env=prod,tier=front-end
Los ReplicaSets, Deployments y Services usan selectores para encontrar sus Pods. Fíjate en que
cuentan las labels de la plantilla del Pod (spec.template.metadata.labels), no las del
metadata del propio ReplicaSet.
metadata:
  name: miapp
  labels:
    app: miapp            # labels del objeto, para que otros lo encuentren
  annotations:
    buildversion: "1.34"  # información, no se usa para seleccionar
Taints y tolerations
Sirven para que un nodo rechace Pods, salvo los que estén preparados para él:
- Un taint ("mancha") se pone en el nodo. Por defecto, ningún Pod lo tolera.
- Una toleration se pone en el Pod y le permite ser programado en nodos con ese taint.
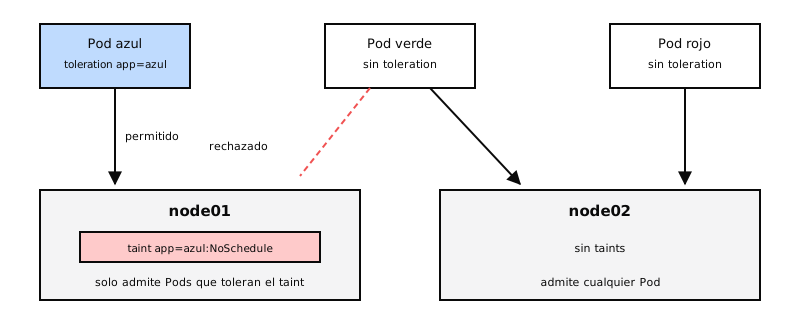
Importante: una toleration no obliga al Pod a ir a ese nodo. Solo le da permiso. El Pod puede acabar en cualquier otro nodo sin taints. Para dirigirlo a un nodo concreto se usa la afinidad, que veremos enseguida.
Paso 1: poner el taint en el nodo
kubectl taint nodes node01 app=azul:NoSchedule

# Quitarlo (con un guion al final)
kubectl taint nodes node01 app=azul:NoSchedule-
| Efecto | Qué hace con los Pods que no lo toleran |
|---|---|
NoSchedule |
No programa Pods nuevos en el nodo. |
PreferNoSchedule |
Intenta evitar el nodo, pero no lo garantiza. |
NoExecute |
No programa Pods nuevos y expulsa a los que ya estaban. |
Paso 2: hacer tolerante al Pod
apiVersion: v1
kind: Pod
metadata:
  name: app-azul
spec:
  containers:
    - name: web
      image: nginx
  tolerations:
    - key: "app"
      operator: "Equal"
      value: "azul"
      effect: "NoSchedule"
Por eso no se programan Pods de aplicaciones en el plano de control: sus nodos llevan el taint
node-role.kubernetes.io/control-plane:NoSchedule.
nodeSelector: elegir nodos por label
La forma más simple de dirigir un Pod a ciertos nodos. Primero etiquetas el nodo y luego lo pides en el Pod:
kubectl label nodes node01 size=large
spec:
  nodeSelector:
    size: large
  containers:
    - name: procesador
      image: mi-procesador
Su límite: solo admite igualdades. No puedes pedir "nodos grandes o medianos" ni "cualquier nodo que no sea pequeño". Para eso está la afinidad.
Node affinity
La afinidad de nodo es la versión avanzada de nodeSelector: admite operadores (In,
NotIn, Exists, DoesNotExist, Gt, Lt) y reglas obligatorias o preferidas.
spec:
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
          - matchExpressions:
              - key: size
                operator: In
                values: ["large", "medium"]
  containers:
    - name: procesador
      image: mi-procesador
Los nombres largos describen el comportamiento en dos momentos:
| Tipo | Al programar el Pod | Si el nodo cambia después |
|---|---|---|
requiredDuringSchedulingIgnoredDuringExecution |
Obligatorio: si ningún nodo cumple, el Pod queda Pending. |
Se ignora: el Pod sigue donde está. |
preferredDuringSchedulingIgnoredDuringExecution |
Preferido: si ningún nodo cumple, va a otro. | Se ignora. |
Para "cualquier nodo que no sea pequeño" usarías operator: NotIn con values: ["small"].
Taints y tolerations frente a affinity
Resuelven problemas distintos y suelen usarse juntos:
- Taints y tolerations evitan que otros Pods entren en tus nodos.
- Node affinity asegura que tus Pods vayan a tus nodos.
Para reservar unos nodos para una aplicación: taint en esos nodos, toleration en los Pods de la aplicación y afinidad para que esos Pods no terminen en otros nodos.
Requests y limits de recursos
Cada contenedor puede declarar cuánta CPU y memoria necesita y cuánta puede usar como máximo:
spec:
  containers:
    - name: web
      image: nginx
      resources:
        requests:
          cpu: "250m"      # 0,25 núcleos
          memory: "256Mi"
        limits:
          cpu: "500m"
          memory: "512Mi"
- requests es lo que usa el scheduler: solo coloca el Pod en un nodo con esa capacidad libre.
- limits es el techo durante la ejecución, y se comporta distinto según el recurso:
| Recurso | Si el contenedor intenta pasar el límite |
|---|---|
| CPU | Se le frena (throttling): va más lento, pero sigue vivo. |
| Memoria | Se termina el contenedor con el error OOMKilled (sin memoria). |
Por defecto Kubernetes no pone requests ni limits. Una práctica común: definir siempre requests y, para CPU, ser prudente con los limits, porque frenan aunque el nodo tenga CPU libre.
Para fijar valores por defecto se usan dos objetos de namespace:
- LimitRange: valores por defecto, mínimos y máximos por contenedor.
- ResourceQuota: el total que puede consumir todo el namespace.
DaemonSets: un Pod en cada nodo
Un DaemonSet garantiza que haya una copia de un Pod en cada nodo del clúster. Cuando se añade un nodo, crea el Pod en él; cuando se quita, lo elimina.
Es lo que se usa para agentes que deben estar en todas partes: monitorización, recolección de logs o la red del clúster (kube-proxy se despliega así).
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: agente-monitoreo
spec:
  selector:
    matchLabels:
      app: agente-monitoreo
  template:
    metadata:
      labels:
        app: agente-monitoreo
    spec:
      containers:
        - name: agente
          image: agente-monitoreo
kubectl get daemonsets
kubectl describe daemonset agente-monitoreo
Desde Kubernetes 1.12, los DaemonSets usan el scheduler normal junto con reglas de afinidad de nodo para colocar cada Pod.
Static Pods
El kubelet puede funcionar sin el plano de control: si le das una carpeta con archivos YAML de Pods, los crea y los mantiene vivos por su cuenta. Son los Static Pods.
- La carpeta se configura en el kubelet (
staticPodPathen su configuración). Lo habitual es/etc/kubernetes/manifests. - Si añades un archivo, el kubelet crea el Pod; si lo modificas, lo recrea; si lo borras, el Pod desaparece.
- Si el nodo forma parte de un clúster, el kubelet publica una copia de solo lectura (mirror
Pod) para que se vea con
kubectl get pods, con el nombre del nodo como sufijo. - Así arranca kubeadm el propio plano de control: kube-apiserver, etcd, kube-scheduler y kube-controller-manager son Static Pods en los nodos del plano de control.
Para verlos en el nodo sin pasar por la API: crictl ps.
| Static Pods | DaemonSets | |
|---|---|---|
| Quién los crea | El kubelet, desde archivos locales | El plano de control, a través de la API |
| Dónde | Solo en el nodo con esos archivos | En todos los nodos (o los que indiques) |
| Uso típico | Componentes del plano de control | Agentes de monitorización y logs |
| Lo ignora el scheduler | Sí | No |
Varios schedulers y perfiles
Kubernetes permite schedulers personalizados que conviven con el de serie. Cada uno tiene un nombre y cada Pod elige con cuál programarse:
spec:
  schedulerName: mi-scheduler
  containers:
    - name: nginx
      image: nginx
Un scheduler adicional se despliega como un Pod o Deployment más, con su propio archivo de configuración:
apiVersion: kubescheduler.config.k8s.io/v1
kind: KubeSchedulerConfiguration
profiles:
  - schedulerName: mi-scheduler
Para saber qué scheduler programó cada Pod:
kubectl get events -o wide
kubectl logs mi-scheduler -n kube-system
Plugins y puntos de extensión
El scheduler está construido con plugins, cada uno enganchado a una fase (punto de extensión):
| Fase | Ejemplos de plugins de serie |
|---|---|
queueSort |
PrioritySort (ordena por prioridad) |
filter |
NodeResourcesFit, NodeName, NodeUnschedulable, TaintToleration, NodeAffinity |
score |
NodeResourcesFit, ImageLocality |
bind |
DefaultBinder |
Además existen puntos intermedios (preFilter, postFilter, preScore, reserve, permit,
preBind, postBind) donde se pueden añadir plugins propios.
En lugar de mantener varios schedulers separados, un mismo kube-scheduler puede tener varios
perfiles, cada uno con su schedulerName y su combinación de plugins activados o desactivados:
apiVersion: kubescheduler.config.k8s.io/v1
kind: KubeSchedulerConfiguration
profiles:
  - schedulerName: default-scheduler
  - schedulerName: sin-puntuacion
    plugins:
      score:
        disabled:
          - name: "*"
Ideas clave
- El scheduler filtra nodos, los puntúa y asigna el Pod escribiendo su
nodeName. nodeNamepermite programar a mano, solo al crear el Pod.- Labels agrupan, selectores filtran y anotaciones solo informan.
- Taints en nodos y tolerations en Pods: el nodo rechaza a quien no tolera.
NoExecuteademás expulsa. - nodeSelector dirige Pods por igualdad de labels; node affinity añade operadores y reglas obligatorias o preferidas.
- requests deciden dónde cabe un Pod; superar el limit de CPU frena, superar el de memoria provoca OOMKilled.
- DaemonSet: un Pod por nodo. Static Pod: creado por el kubelet desde archivos locales.
- Se pueden usar varios schedulers o perfiles, elegidos con
schedulerName.