Kubernetes · Capítulo 2
Recursos de Kubernetes
Pods, ReplicaSets y Deployments, cómo se actualizan y revierten, el enfoque declarativo con kubectl apply y la organización con Namespaces.
En el capítulo anterior vimos la arquitectura del clúster. Ahora toca lo que se despliega en él: los recursos (u objetos) de Kubernetes. Recorreremos la cadena que usarás a diario, Pod → ReplicaSet → Deployment, cómo se actualiza una aplicación sin cortes y cómo se organiza todo con Namespaces.
Pods: la unidad mínima
Kubernetes no ejecuta contenedores sueltos: los envuelve en un Pod, la unidad más pequeña que se puede crear y programar en un nodo.
- Lo normal es un contenedor por Pod. Para escalar se crean más Pods, no más contenedores dentro del mismo Pod.
- Un Pod puede tener varios contenedores cuando trabajan juntos de forma inseparable. Por
ejemplo, un sidecar que recoge logs o el proxy de una service mesh. Esos contenedores
comparten red (se ven en
localhost) y almacenamiento.
Definir un Pod en YAML
Todo objeto de Kubernetes se describe con cuatro campos de primer nivel:
| Campo | Para qué sirve |
|---|---|
apiVersion |
Versión de la API del objeto (v1 para Pods). |
kind |
Tipo de objeto: Pod, ReplicaSet, Deployment... |
metadata |
Nombre, etiquetas (labels) y otros datos del objeto. |
spec |
El estado deseado: en un Pod, sus contenedores. |
apiVersion: v1
kind: Pod
metadata:
  name: mi-pod
  labels:
    app: miapp
    tier: front-end
spec:
  containers:
    - name: web
      image: nginx
      ports:
        - containerPort: 80
Comandos básicos
# Crear un Pod rápido, sin YAML (la imagen debe existir en el registro)
kubectl run nginx --image=nginx

# Crear o actualizar a partir del archivo
kubectl apply -f mi-pod.yaml

# Consultar
kubectl get pods                 # Pods del namespace actual
kubectl get pods -o wide         # con la IP y el nodo de cada Pod
kubectl get pods -A              # Pods de todos los namespaces
kubectl describe pod nginx       # detalle y eventos del Pod
ReplicaSets: varias copias, siempre vivas
Un Pod solo no es resiliente: si muere, nadie lo reemplaza. El ReplicaSet es un controlador que garantiza que siempre haya un número determinado de Pods iguales en ejecución:
- Alta disponibilidad: si un Pod cae, crea otro.
- Escalado y reparto de carga: las réplicas pueden distribuirse entre varios nodos.
Su antecesor era el ReplicationController, hoy considerado legado. El ReplicaSet hace lo mismo y añade un selector más flexible.
Selector y labels: cómo sabe qué Pods vigilar
El ReplicaSet no "recuerda" los Pods que creó: los busca por sus labels. El campo
selector.matchLabels dice qué labels deben tener los Pods que le pertenecen, y la plantilla
(template) define cómo crear los que falten.
apiVersion: apps/v1
kind: ReplicaSet
metadata:
  name: miapp-replicaset
  labels:
    app: miapp
spec:
  replicas: 3
  selector:
    matchLabels:
      app: miapp
      tier: front-end
  template:                 # plantilla de los Pods
    metadata:
      labels:
        app: miapp          # deben coincidir con el selector
        tier: front-end
    spec:
      containers:
        - name: web
          image: nginx
          ports:
            - containerPort: 80
Dos consecuencias importantes:
- Un ReplicaSet puede adoptar Pods que ya existían si tienen las labels del selector.
- Si creas a mano un Pod con esas mismas labels y ya se alcanzó el número de réplicas, el ReplicaSet lo elimina: nunca deja que haya más copias de las indicadas.
Escalar un ReplicaSet
kubectl get replicasets            # o: kubectl get rs
kubectl describe rs miapp-replicaset

# Opción 1: cambiar replicas en el YAML y aplicar
kubectl replace -f miapp-replicaset.yaml

# Opción 2: escalar desde la línea de comandos
kubectl scale rs miapp-replicaset --replicas=6
Ojo:
kubectl scalecambia el objeto en el clúster, no tu archivo YAML. Si después aplicas el archivo, volverás al número de réplicas que diga el archivo.
Deployments: la forma habitual de desplegar
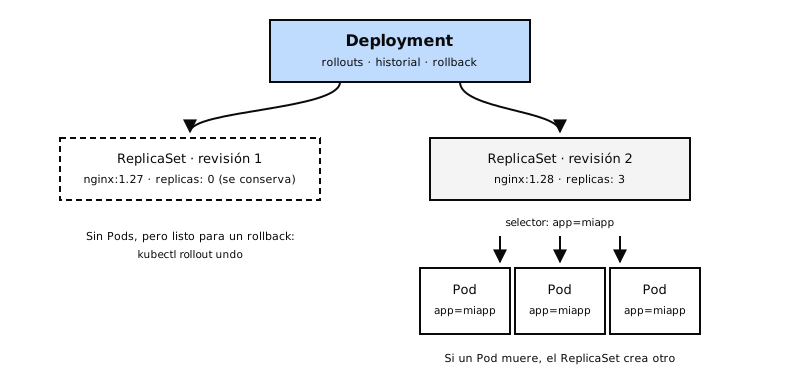
En la práctica casi nunca se crean ReplicaSets a mano. Se usa un Deployment, un objeto de nivel superior que crea y gestiona ReplicaSets por ti y añade lo que un ReplicaSet no sabe hacer: actualizar la aplicación de forma controlada y volver atrás.
Su YAML es casi idéntico al del ReplicaSet; cambia el kind:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: miapp-deployment
  labels:
    app: miapp
spec:
  replicas: 3
  selector:
    matchLabels:
      app: miapp
  template:
    metadata:
      labels:
        app: miapp
    spec:
      containers:
        - name: web
          image: nginx:1.27
          ports:
            - containerPort: 80
kubectl apply -f miapp-deployment.yaml
kubectl get deployments
kubectl get rs          # el ReplicaSet que creó el Deployment
kubectl get pods
kubectl get all         # todo lo anterior de un vistazo
Rollouts, revisiones y rollback
Cada vez que cambias la plantilla de Pods de un Deployment (por ejemplo, la imagen), Kubernetes lanza un rollout y guarda una revisión. Por dentro, el Deployment crea un ReplicaSet nuevo con la versión nueva y va pasando los Pods del ReplicaSet viejo al nuevo.
# Seguir el progreso y ver el historial
kubectl rollout status deployment/miapp-deployment
kubectl rollout history deployment/miapp-deployment

# Actualizar la imagen sin editar el archivo
kubectl set image deployment/miapp-deployment web=nginx:1.28

# Volver a la revisión anterior (o a una concreta)
kubectl rollout undo deployment/miapp-deployment
kubectl rollout undo deployment/miapp-deployment --to-revision=1
Como el ReplicaSet anterior se conserva (con cero réplicas), el rollback es rápido: Kubernetes solo tiene que volver a escalarlo.
Sobre
--record: en muchas guías veráskubectl apply --recordpara guardar el comando en el historial. Esa opción está obsoleta. Hoy se anota el motivo del cambio así:kubectl annotate deployment/miapp-deployment kubernetes.io/change-cause="nginx 1.28"
Estrategias de despliegue
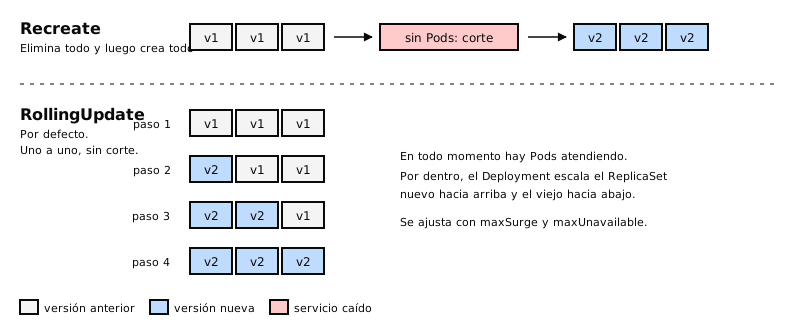
| Estrategia | Cómo funciona | ¿Hay corte? |
|---|---|---|
| RollingUpdate (por defecto) | Reemplaza los Pods poco a poco: crea uno nuevo, elimina uno viejo, y así sucesivamente. | No |
| Recreate | Elimina todos los Pods viejos y después crea todos los nuevos. | Sí, mientras arrancan los nuevos |
Se elige en spec.strategy.type del Deployment.
Imperativo frente a declarativo
Hay dos formas de trabajar con Kubernetes:
- Imperativa: le dices al sistema qué hacer y cómo, paso a paso: crea esto, cambia aquello, borra lo otro.
- Declarativa: describes el estado final en archivos y el sistema calcula qué cambios hacen falta para llegar a él.
| Imperativo | Declarativo |
|---|---|
kubectl run, kubectl create, kubectl expose |
kubectl apply -f archivo.yaml |
kubectl scale, kubectl set image |
kubectl apply -f carpeta/ |
kubectl edit (cambia el clúster, no tu archivo) |
El archivo es la fuente de verdad |
kubectl replace --force -f (borra y recrea) |
Se puede versionar en Git |
Lo imperativo es útil para pruebas rápidas y en exámenes con tiempo limitado. Para entornos reales, lo declarativo es lo recomendable: el archivo en Git refleja siempre lo que hay en el clúster.
Cómo funciona kubectl apply
kubectl apply compara tres versiones de cada objeto para decidir qué cambiar:
- Tu archivo local (lo que quieres).
- El objeto vivo en el clúster (lo que hay).
- La última configuración aplicada, que Kubernetes guarda en formato JSON como anotación del
objeto, con la clave
kubectl.kubernetes.io/last-applied-configuration.
Gracias a la tercera, apply sabe si quitaste un campo de tu archivo y debe borrarlo del objeto
vivo, en lugar de dejarlo como estaba. Si el objeto no existe, simplemente lo crea.
Namespaces: organizar el clúster
Un Namespace es un espacio aislado dentro del clúster, con sus propios recursos, permisos y límites. Sirve para separar entornos (desarrollo, pruebas, producción) o equipos.
Kubernetes trae varios de serie:
| Namespace | Para qué se usa |
|---|---|
default |
Donde se crean los recursos si no indicas otro. |
kube-system |
Componentes internos de Kubernetes. No se toca. |
kube-public |
Recursos legibles por todos los usuarios, incluso sin autenticar. |
kube-node-lease |
Señales de vida (heartbeats) de los nodos. |
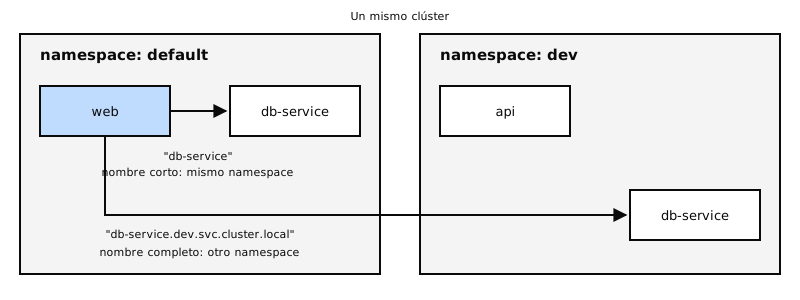
Nombres DNS entre namespaces
Dentro del mismo namespace, un servicio se alcanza por su nombre (db-service). Para llegar a
uno de otro namespace se usa el nombre completo:
db-service.dev.svc.cluster.local
└─servicio─┘└ns┘└tipo┘└─dominio del clúster─┘
Trabajar con namespaces
# Crear
kubectl create namespace dev

# Ver recursos de un namespace concreto o de todos
kubectl get pods --namespace=dev
kubectl get pods --all-namespaces

# Cambiar el namespace por defecto de tu contexto
kubectl config set-context --current --namespace=dev
Para que un objeto se cree siempre en un namespace, ponlo en su metadata:
metadata:
  name: mi-pod
  namespace: dev
Limitar recursos con ResourceQuota
Un ResourceQuota fija el máximo de recursos que puede consumir un namespace en total:
apiVersion: v1
kind: ResourceQuota
metadata:
  name: cuota-dev
  namespace: dev
spec:
  hard:
    pods: "10"
    requests.cpu: "4"
    requests.memory: 5Gi
    limits.cpu: "10"
    limits.memory: 10Gi
Ideas clave
- El Pod es la unidad mínima; normalmente lleva un solo contenedor.
- Todo objeto tiene
apiVersion,kind,metadatayspec. - El ReplicaSet mantiene N copias de un Pod y las encuentra por labels con su
selector. - El Deployment gestiona ReplicaSets y añade rollouts, historial y rollback.
- RollingUpdate (por defecto) no corta el servicio; Recreate sí.
- Lo declarativo (
kubectl apply) es lo recomendado;applyusa la anotaciónlast-applied-configurationpara calcular los cambios. - Los Namespaces separan recursos; entre ellos se usa el DNS
servicio.namespace.svc.cluster.local, y un ResourceQuota limita su consumo.
En el próximo capítulo: scheduling, cómo decide Kubernetes en qué nodo va cada Pod.