Kubernetes · Chapitre 2
Les ressources de Kubernetes
Pods, ReplicaSets et Deployments, leur mise à jour et leur retour arrière, l'approche déclarative avec kubectl apply et l'organisation avec les Namespaces.
Dans le chapitre précédent, nous avons vu l'architecture du cluster. Place maintenant à ce que l'on y déploie : les ressources (ou objets) de Kubernetes. Nous allons parcourir la chaîne que vous utiliserez au quotidien, Pod → ReplicaSet → Deployment, voir comment mettre à jour une application sans coupure et comment tout organiser avec les Namespaces.
Les Pods : l'unité minimale
Kubernetes n'exécute pas de conteneurs isolés : il les enveloppe dans un Pod, la plus petite unité que l'on peut créer et placer sur un nœud.
- La règle est un conteneur par Pod. Pour monter en charge, on crée plus de Pods, pas plus de conteneurs dans le même Pod.
- Un Pod peut contenir plusieurs conteneurs quand ils fonctionnent ensemble de façon
indissociable. Par exemple, un sidecar qui collecte les logs ou le proxy d'un service mesh.
Ces conteneurs partagent le réseau (ils se voient sur
localhost) et le stockage.
Définir un Pod en YAML
Tout objet Kubernetes est décrit par quatre champs de premier niveau :
| Champ | À quoi il sert |
|---|---|
apiVersion |
Version de l'API de l'objet (v1 pour les Pods). |
kind |
Type d'objet : Pod, ReplicaSet, Deployment... |
metadata |
Nom, labels et autres données de l'objet. |
spec |
L'état souhaité : pour un Pod, ses conteneurs. |
apiVersion: v1
kind: Pod
metadata:
  name: mi-pod
  labels:
    app: miapp
    tier: front-end
spec:
  containers:
    - name: web
      image: nginx
      ports:
        - containerPort: 80
Commandes de base
# Créer rapidement un Pod, sans YAML (l'image doit exister dans le registre)
kubectl run nginx --image=nginx

# Créer ou mettre à jour à partir du fichier
kubectl apply -f mi-pod.yaml

# Consulter
kubectl get pods                 # Pods du namespace courant
kubectl get pods -o wide         # avec l'IP et le nœud de chaque Pod
kubectl get pods -A              # Pods de tous les namespaces
kubectl describe pod nginx       # détails et événements du Pod
Les ReplicaSets : plusieurs copies, toujours actives
Un Pod seul n'est pas résilient : s'il meurt, personne ne le remplace. Le ReplicaSet est un contrôleur qui garantit qu'il y a toujours un nombre donné de Pods identiques en cours d'exécution :
- Haute disponibilité : si un Pod tombe, il en crée un autre.
- Mise à l'échelle et répartition de charge : les réplicas peuvent être répartis sur plusieurs nœuds.
Son prédécesseur était le ReplicationController, aujourd'hui considéré comme obsolète. Le ReplicaSet fait la même chose et ajoute un sélecteur plus souple.
Sélecteur et labels : comment il sait quels Pods surveiller
Le ReplicaSet ne « se souvient » pas des Pods qu'il a créés : il les retrouve grâce à leurs
labels. Le champ selector.matchLabels indique les labels que doivent porter les Pods qui lui
appartiennent, et le modèle (template) définit comment créer ceux qui manquent.
apiVersion: apps/v1
kind: ReplicaSet
metadata:
  name: miapp-replicaset
  labels:
    app: miapp
spec:
  replicas: 3
  selector:
    matchLabels:
      app: miapp
      tier: front-end
  template:                 # modèle des Pods
    metadata:
      labels:
        app: miapp          # doivent correspondre au sélecteur
        tier: front-end
    spec:
      containers:
        - name: web
          image: nginx
          ports:
            - containerPort: 80
Deux conséquences importantes :
- Un ReplicaSet peut adopter des Pods qui existaient déjà s'ils portent les labels du sélecteur.
- Si vous créez à la main un Pod avec ces mêmes labels alors que le nombre de réplicas est déjà atteint, le ReplicaSet le supprime : il ne laisse jamais plus de copies que demandé.
Mettre à l'échelle un ReplicaSet
kubectl get replicasets            # ou : kubectl get rs
kubectl describe rs miapp-replicaset

# Option 1 : modifier replicas dans le YAML et l'appliquer
kubectl replace -f miapp-replicaset.yaml

# Option 2 : mettre à l'échelle depuis la ligne de commande
kubectl scale rs miapp-replicaset --replicas=6
Attention :
kubectl scalemodifie l'objet dans le cluster, pas votre fichier YAML. Si vous appliquez le fichier ensuite, vous reviendrez au nombre de réplicas indiqué dans le fichier.
Les Deployments : la façon habituelle de déployer
En pratique, on ne crée presque jamais de ReplicaSets à la main. On utilise un Deployment, un objet de plus haut niveau qui crée et gère les ReplicaSets pour vous et ajoute ce qu'un ReplicaSet ne sait pas faire : mettre à jour l'application de façon contrôlée et revenir en arrière.
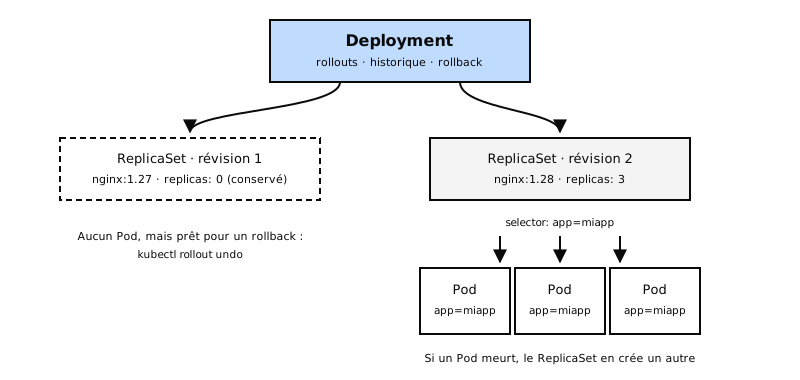
Son YAML est presque identique à celui du ReplicaSet ; seul le kind change :
apiVersion: apps/v1
kind: Deployment
metadata:
  name: miapp-deployment
  labels:
    app: miapp
spec:
  replicas: 3
  selector:
    matchLabels:
      app: miapp
  template:
    metadata:
      labels:
        app: miapp
    spec:
      containers:
        - name: web
          image: nginx:1.27
          ports:
            - containerPort: 80
kubectl apply -f miapp-deployment.yaml
kubectl get deployments
kubectl get rs          # le ReplicaSet créé par le Deployment
kubectl get pods
kubectl get all         # tout ce qui précède d'un coup d'œil
Rollouts, révisions et rollback
Chaque fois que vous modifiez le modèle de Pods d'un Deployment (par exemple l'image), Kubernetes lance un rollout et enregistre une révision. En interne, le Deployment crée un nouveau ReplicaSet avec la nouvelle version et fait passer progressivement les Pods de l'ancien ReplicaSet vers le nouveau.
# Suivre la progression et voir l'historique
kubectl rollout status deployment/miapp-deployment
kubectl rollout history deployment/miapp-deployment

# Mettre à jour l'image sans modifier le fichier
kubectl set image deployment/miapp-deployment web=nginx:1.28

# Revenir à la révision précédente (ou à une révision précise)
kubectl rollout undo deployment/miapp-deployment
kubectl rollout undo deployment/miapp-deployment --to-revision=1
Comme l'ancien ReplicaSet est conservé (avec zéro réplica), le rollback est rapide : Kubernetes n'a qu'à le remettre à l'échelle.
À propos de
--record: beaucoup de guides utilisentkubectl apply --recordpour enregistrer la commande dans l'historique. Cette option est obsolète. Aujourd'hui, on annote la raison du changement ainsi :kubectl annotate deployment/miapp-deployment kubernetes.io/change-cause="nginx 1.28"
Stratégies de déploiement
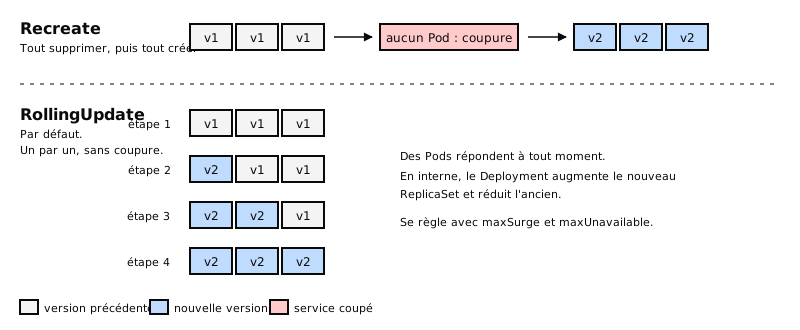
| Stratégie | Fonctionnement | Coupure ? |
|---|---|---|
| RollingUpdate (par défaut) | Remplace les Pods progressivement : crée un nouveau, supprime un ancien, et ainsi de suite. | Non |
| Recreate | Supprime tous les anciens Pods puis crée tous les nouveaux. | Oui, le temps que les nouveaux démarrent |
On la choisit dans spec.strategy.type du Deployment.
Impératif ou déclaratif
Il existe deux façons de travailler avec Kubernetes :
- Impérative : vous dites au système quoi faire et comment, étape par étape : crée ceci, modifie cela, supprime le reste.
- Déclarative : vous décrivez l'état final dans des fichiers et le système calcule les changements nécessaires pour y parvenir.
| Impératif | Déclaratif |
|---|---|
kubectl run, kubectl create, kubectl expose |
kubectl apply -f fichier.yaml |
kubectl scale, kubectl set image |
kubectl apply -f dossier/ |
kubectl edit (modifie le cluster, pas votre fichier) |
Le fichier est la source de vérité |
kubectl replace --force -f (supprime et recrée) |
Il peut être versionné dans Git |
L'impératif est pratique pour des tests rapides et lors d'examens chronométrés. Pour les environnements réels, le déclaratif est recommandé : le fichier dans Git reflète toujours ce qu'il y a dans le cluster.
Comment fonctionne kubectl apply
kubectl apply compare trois versions de chaque objet pour décider quoi modifier :
- Votre fichier local (ce que vous voulez).
- L'objet vivant dans le cluster (ce qui existe).
- La dernière configuration appliquée, que Kubernetes stocke en JSON comme annotation de
l'objet, sous la clé
kubectl.kubernetes.io/last-applied-configuration.
Grâce à la troisième, apply sait si vous avez retiré un champ de votre fichier et s'il doit le
supprimer de l'objet vivant, au lieu de le laisser tel quel. Si l'objet n'existe pas, il le crée
simplement.
Les Namespaces : organiser le cluster
Un Namespace est un espace isolé à l'intérieur du cluster, avec ses propres ressources, permissions et limites. Il sert à séparer des environnements (développement, test, production) ou des équipes.
Kubernetes en fournit plusieurs d'office :
| Namespace | Utilisation |
|---|---|
default |
Là où les ressources sont créées si vous n'en indiquez pas d'autre. |
kube-system |
Composants internes de Kubernetes. On n'y touche pas. |
kube-public |
Ressources lisibles par tous les utilisateurs, même non authentifiés. |
kube-node-lease |
Signaux de vie (heartbeats) des nœuds. |
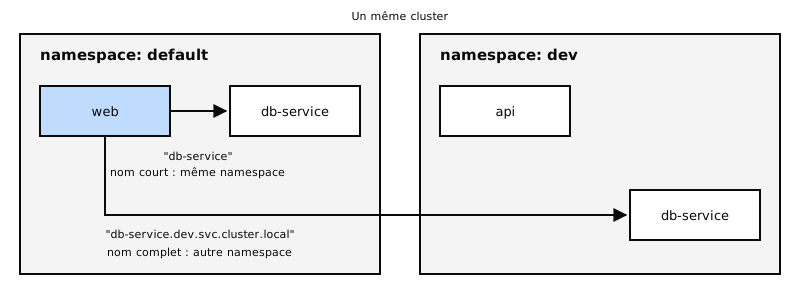
Noms DNS entre namespaces
Dans le même namespace, on joint un service par son nom (db-service). Pour en joindre un dans
un autre namespace, on utilise le nom complet :
db-service.dev.svc.cluster.local
└─service──┘└ns┘└type┘└─domaine du cluster─┘
Travailler avec les namespaces
# Créer
kubectl create namespace dev

# Voir les ressources d'un namespace précis ou de tous
kubectl get pods --namespace=dev
kubectl get pods --all-namespaces

# Changer le namespace par défaut de votre contexte
kubectl config set-context --current --namespace=dev
Pour qu'un objet soit toujours créé dans un namespace, indiquez-le dans son metadata :
metadata:
  name: mi-pod
  namespace: dev
Limiter les ressources avec ResourceQuota
Un ResourceQuota fixe le maximum de ressources qu'un namespace peut consommer au total :
apiVersion: v1
kind: ResourceQuota
metadata:
  name: cuota-dev
  namespace: dev
spec:
  hard:
    pods: "10"
    requests.cpu: "4"
    requests.memory: 5Gi
    limits.cpu: "10"
    limits.memory: 10Gi
À retenir
- Le Pod est l'unité minimale ; il contient généralement un seul conteneur.
- Tout objet a
apiVersion,kind,metadataetspec. - Le ReplicaSet maintient N copies d'un Pod et les retrouve par leurs labels grâce à son
selector. - Le Deployment gère des ReplicaSets et ajoute rollouts, historique et rollback.
- RollingUpdate (par défaut) n'interrompt pas le service ; Recreate, si.
- Le déclaratif (
kubectl apply) est recommandé ;applyutilise l'annotationlast-applied-configurationpour calculer les changements. - Les Namespaces séparent les ressources ; entre eux, on utilise le nom DNS
service.namespace.svc.cluster.local, et un ResourceQuota limite leur consommation.
Dans le prochain chapitre : le scheduling, ou comment Kubernetes décide sur quel nœud va chaque Pod.